悟客接入决策模型之前,我们测了 23 个
一个多月里,我们在已脱敏的真实客服对话上测了 23 个 Jev 类决策模型,随后在悟客里接入了决策模型,用于对话分派和会话结束后的客户状态判断。本文写测试里看到的差距、接入时的取舍,以及它还判不了的地方。
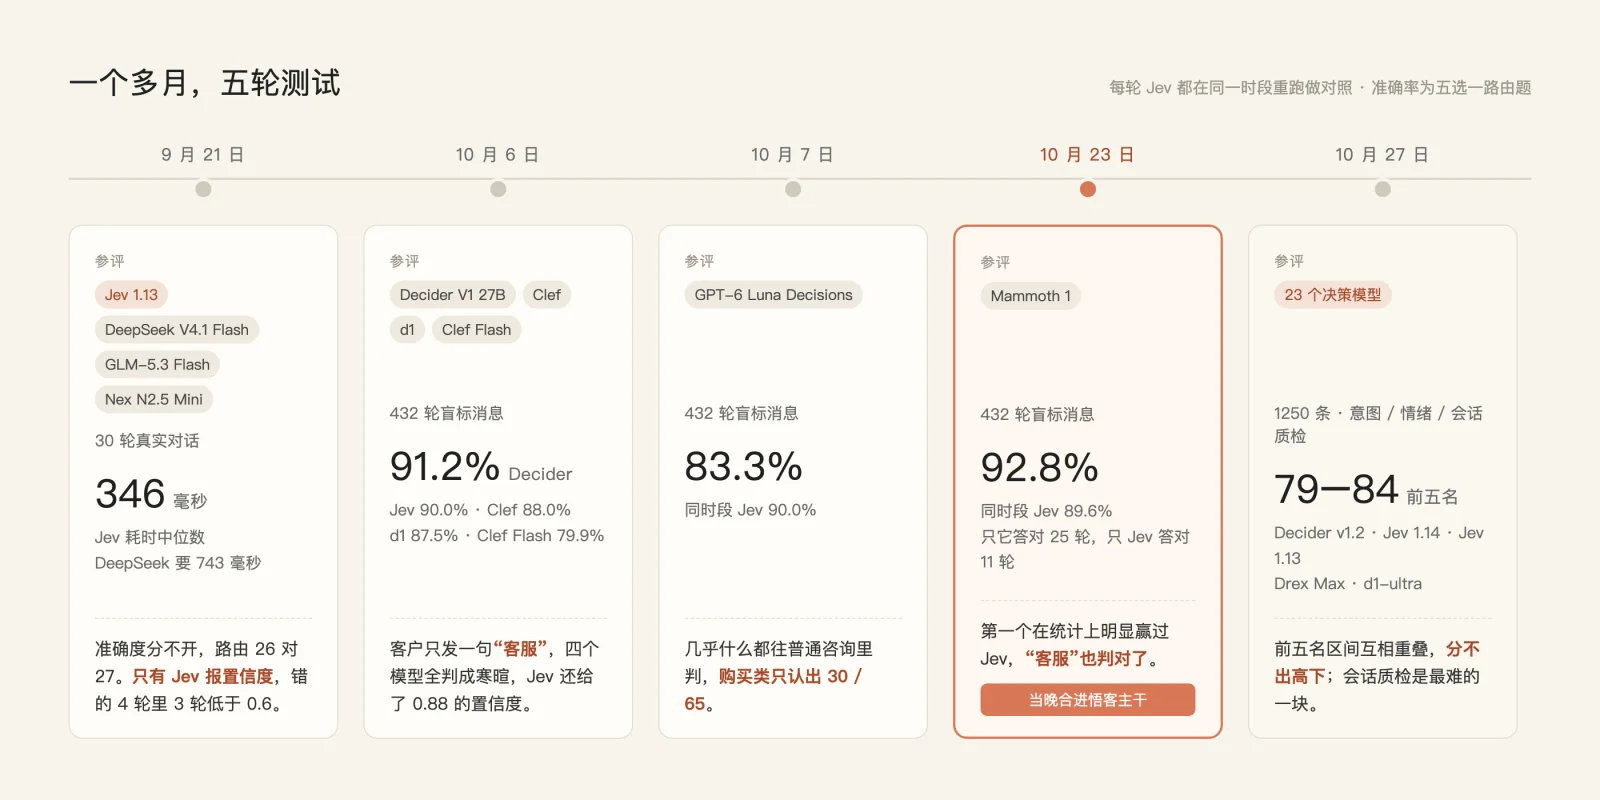
9 月 21 日,我们第一次把 Jev 放到自己的客服数据上跑。Jev 是 TypeSafe 出的决策模型,它不写回复,只回答选择题、打分题和是非题,每个答案附一组概率。对照组是关掉思考的 DeepSeek V4.1 Flash,同样 30 轮真实对话,同样七道题。
准确度没拉开。五选一的路由题,Jev 对了 26 轮,DeepSeek 对了 27 轮,30 个样本分不出谁好谁坏。让我们决定继续测下去的是另外两个数。Jev 的耗时中位数是 346 毫秒,DeepSeek 要 743 毫秒。Jev 答错的 4 轮里,有 3 轮自己报的置信度低于 0.6,DeepSeek 只给答案,错了也不吭声。
客服路由最缺的,就是一个肯说"这题我没把握"的模型。
两个字难住了所有模型
悟客的流程里有一步是分派。客户发来一句话,系统决定交给哪位专员,售后排障、换芯指导或者售前推荐,也可能谁都不交。这一步原来由大模型来做,能用,就是每轮都得等它把答案写完,偶尔还会写出格式不对的东西。
决策模型只给一个选项和一个把握程度,路由要的正好是这两样。它能不能读懂中文客服的话,得拿我们自己的数据测。
接下来一个多月,OpenRouter 的决策接口上陆续出了一批同类模型,Cloudflare 的 Clef,Liquid 的 d1,Perplexity 的 Decider,OpenAI 的 GPT-6 Luna Decisions,Baseten 的 Mammoth。每出一个,我们就拿同一批盲标过的 432 轮客户消息跑一遍,Jev 在同一时段一起重跑做对照。数据来自已脱敏的真实客服对话。
10 月 6 日那轮,有一条错误所有模型都犯了。客户只发了两个字,"客服"。人一看就知道这是要找人工,四个模型全判成了寒暄,Jev 还给了 0.88 的置信度。错得这么整齐,毛病多半出在题目上。选项说明里写了要求人工、投诉、催单,没写客户只喊一声"客服"算什么,模型就照字面当成了打招呼。我们在"是否要人工"这道题里补了一句,单独发"客服"或"人工"也算要求人工。后来悟客里用的题目,也带着这一句。
GPT-6 Luna 第二天测完,432 轮对了 83.3%,比 Jev 低将近 7 个点,它几乎把什么都往普通咨询里判。Clef、d1 和 Perplexity 的 Decider 跟 Jev 在同一档,配对检验分不开。
10 月 23 日测 Mammoth。432 轮对了 92.8%,Jev 同时段是 89.6%。只有 Jev 答对的有 11 轮,只有 Mammoth 答对的有 25 轮,它是第一个在统计上明显赢过 Jev 的模型,那句"客服"它也判对了。当天晚上,决策模型的支持合进了悟客主干。
在悟客里,它先答,答不好就让开
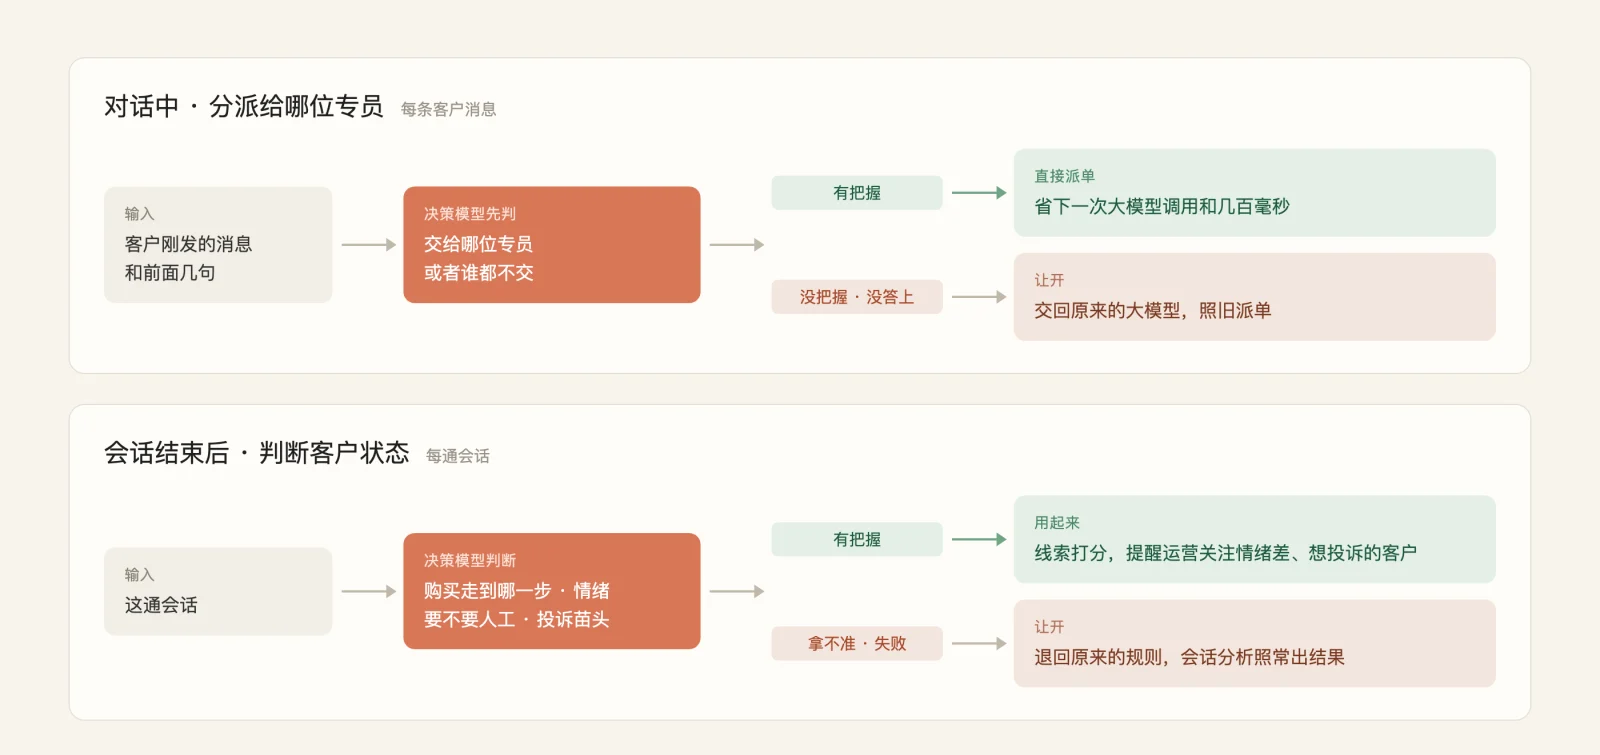
接进去的地方有两处。
第一处在对话里。分派的时候先问决策模型,它有把握就直接派给对应的专员;没把握,或者没在规定时间里答上来,就照旧交给原来的大模型处理。每一轮是谁做的决定,运营人员在后台都看得到。
第二处在会话结束以后。决策模型读一遍这通会话,判断客户走到了购买的哪一步,情绪怎样,要不要人工跟进,有没有投诉的苗头。这些判断用来给线索打分、提醒运营去看那些情绪不好或者想投诉的客户,投诉提醒是这次新加的。哪一项它拿不准,就退回原来的规则;整个调用失败,会话分析照常出结果。
我们不想让决策模型变成新的故障点。它答得好,省下一次大模型调用和几百毫秒;答不好,系统就当它没来过。每个项目都能自己决定开不开,用哪个模型也能换。
接进来以后,又测了一轮大的
之前几轮只测了路由。接进悟客以后,情绪判断和会话质检也要用上决策模型,这些题我们从没系统测过,所以 10 月 27 日又做了一轮更全的。
维度参考了 Hugging Face 上社区维护的 Jev Decision Index。那份榜单把决策能力分成五块,跟客服沾边的主要是意图分类和情感判断,另外还有一类专门核查回答有没有依据。我们照这个思路,从已脱敏的真实客服对话里取了 1250 条,题目分成四组,有轮次路由,有整通会话的诉求和质检,有单句情绪,还有 AI 说"已帮您……"的时候到底做没做到。OpenRouter 决策接口上能调通的模型一共 23 个,全部跑了一遍。
算分也照那份榜单的办法,乱猜是 0 分,全对是 100 分,没答出来按答错算。路由题沿用之前的盲标答案,其余题由我们分两遍独立盲标,两遍一致才算数,标注时看不到任何模型的答案。
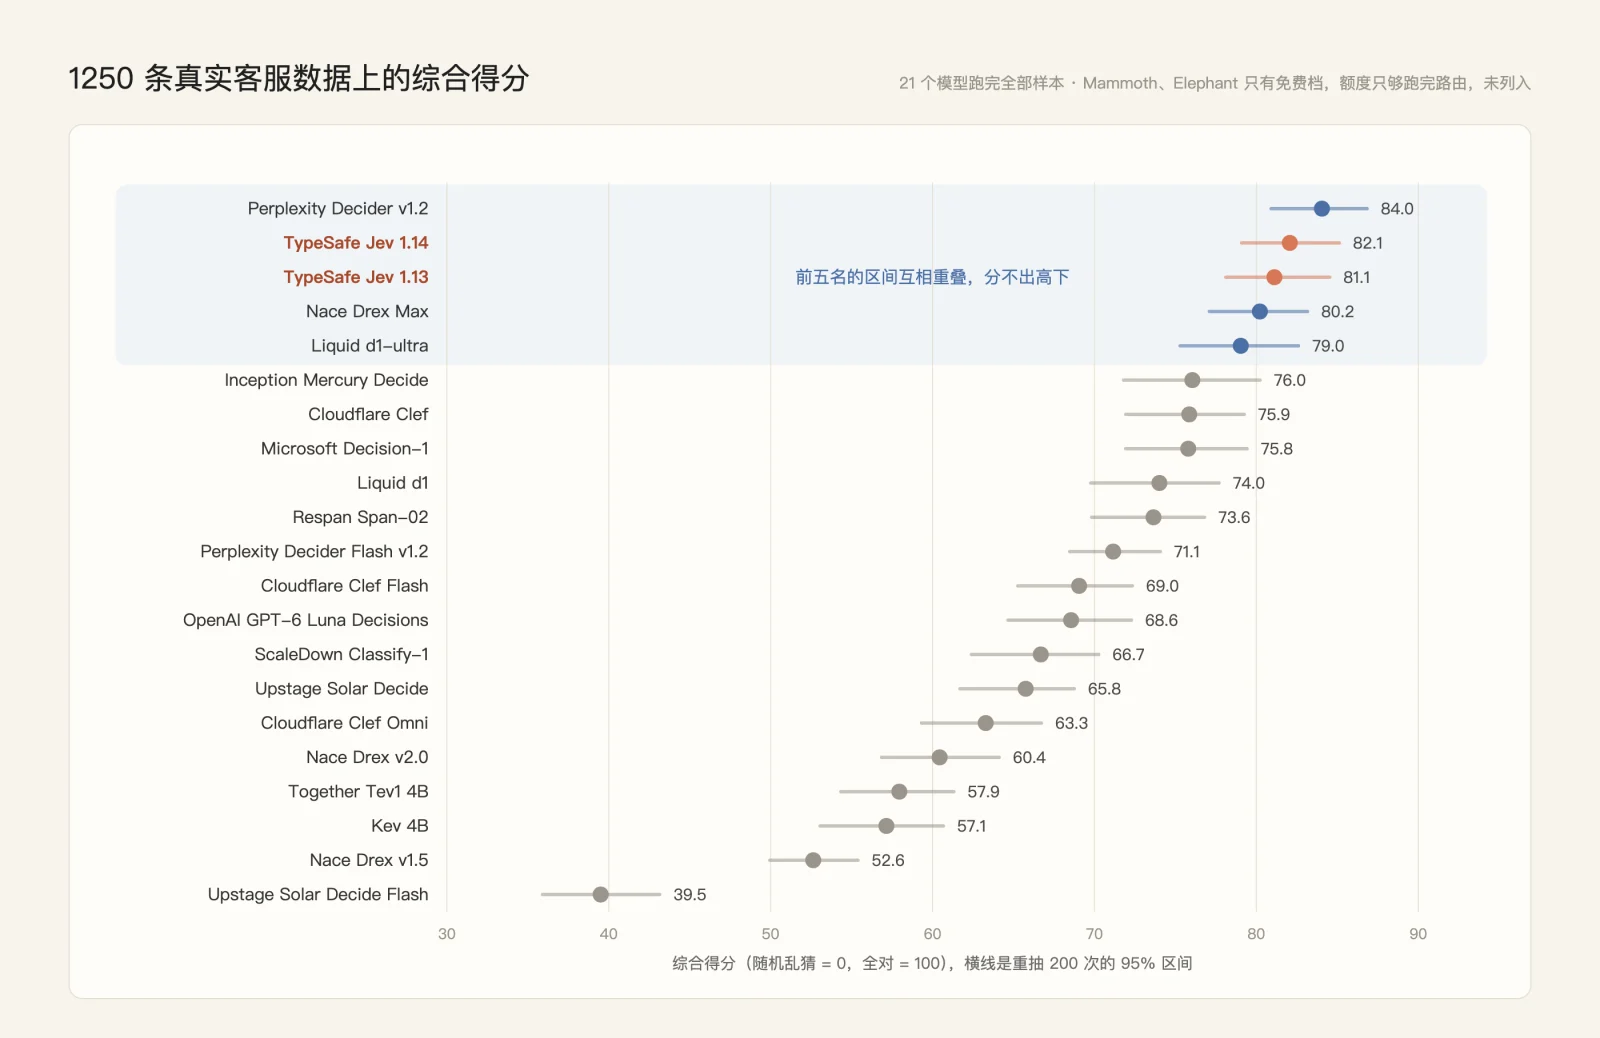
前五名是 Perplexity Decider v1.2、Jev 1.14、Jev 1.13、Nace Drex Max 和 Liquid d1-ultra,分数在 79 到 84 之间。我们把样本有放回地重抽了 200 次,Decider v1.2 赢 Jev 1.14 的次数占八成,另外三家都不到两成,这点差距说不上谁更强。从第六名往下,差距就站得住了。
| 模型 | 综合分 | 95% 区间 | 耗时中位数 | 每千次调用 | 两遍完全一致 |
|---|---|---|---|---|---|
| Perplexity Decider v1.2 | 84.0 | 80.9 到 86.8 | 431 毫秒 | 0.014 美元 | 100% |
| TypeSafe Jev 1.14 | 82.1 | 79.1 到 85.1 | 341 毫秒 | 0.050 美元 | 95% |
| TypeSafe Jev 1.13 | 81.1 | 78.1 到 84.5 | 367 毫秒 | 0.050 美元 | 91% |
| Nace Drex Max | 80.2 | 77.1 到 83.2 | 521 毫秒 | 0.119 美元 | 99% |
| Liquid d1-ultra | 79.0 | 75.3 到 82.6 | 435 毫秒 | 0.031 美元 | 84% |
前五名里选谁,要看分数以外的东西。Jev 1.14 最快,中位数 341 毫秒。Decider v1.2 最便宜,每千次调用 0.014 美元,不到 Jev 的三成;"要不要人工"这道题,11 个该转人工的它全抓住了,Jev 漏了 3 个。d1-ultra 的质检题做得好,可同一个请求跑两遍,有 16% 的样本至少一个判断前后不一样,拿它出质检报表,这周和上周就没法比。Mammoth 目前只有免费档,每天的免费额度只够它跑完路由这一组,路由上它和 Decider v1.2 不相上下。
改过的题目会偏向改它的人
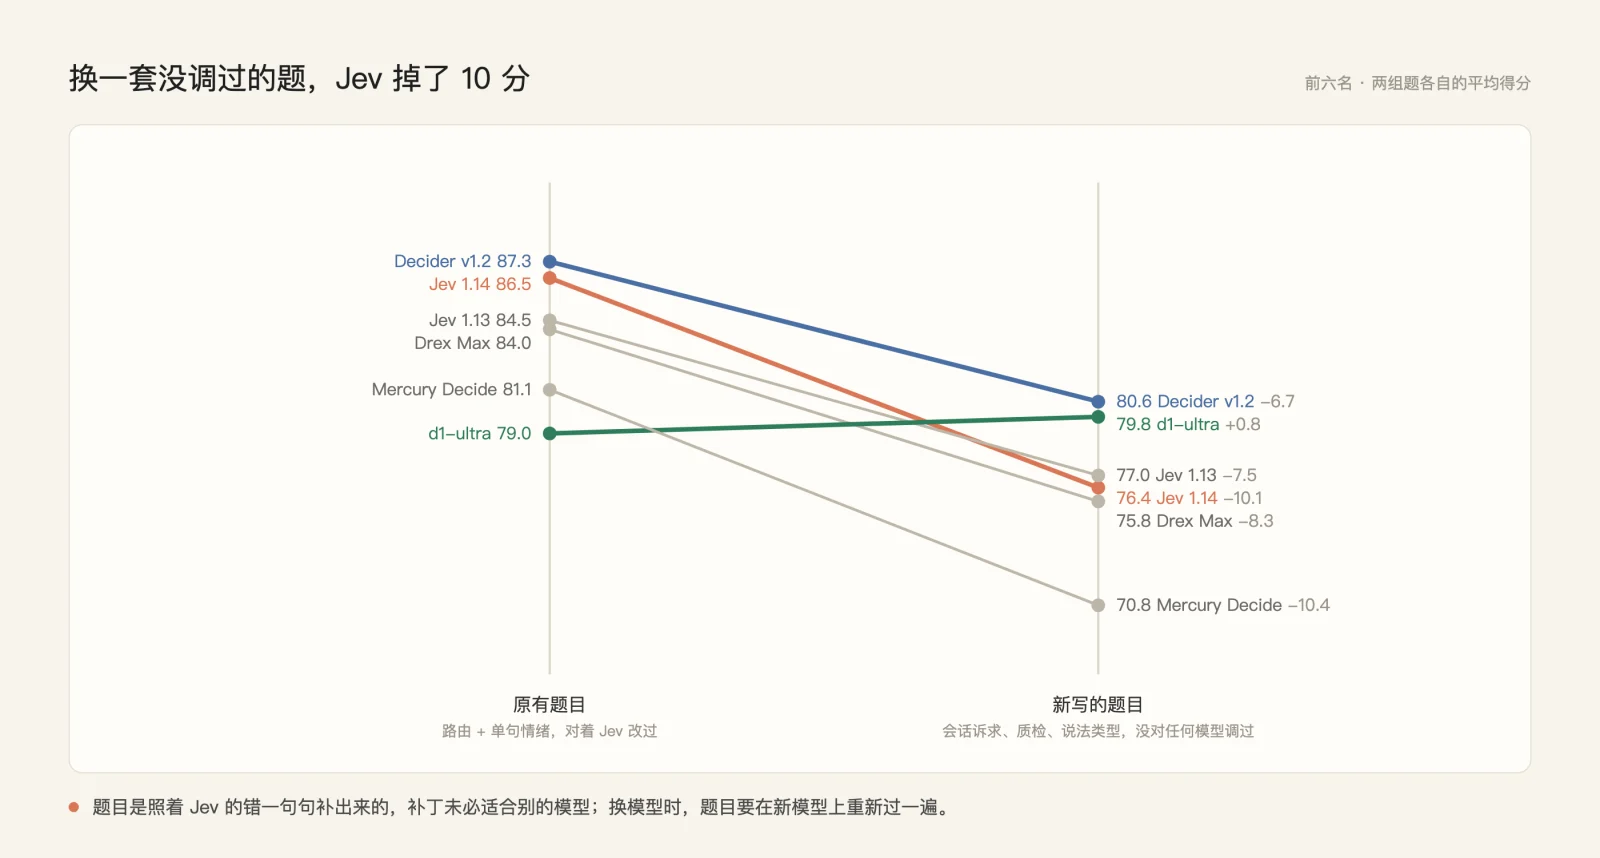
有一组数让我们愣了一下。路由和单句情绪那几道题,措辞是当初对着 Jev 的错误一句一句改出来的,Jev 1.14 在这部分得 86.5。换到这次新写的会话诉求、质检和说法类型题,它掉到 76.4。d1-ultra 在两组题上的分数几乎一样,79.0 和 79.8。Decider v1.2 也掉了,掉得比 Jev 少,新题上排第一。
想想也合理。每次 Jev 判错,我们补的都是 Jev 没读懂的那半句话,补着补着,题目就顺着 Jev 的读法长成了现在的样子。换一个模型,这些补丁对它未必有用。评测给出的分数,算的是模型和这套题目写法放在一起的效果。前五名既然分不出高下,悟客要守住两件事。模型随时能换;换上来的模型要用同一套题目重新验一遍,再照着它判错的地方把题目改一轮。
它还判不了的
有几类错,换哪个模型都一样。
客户问"你好 这个是给我发错了吗",21 个跑完全部样本的模型没有一个判对。发错货属于售后,可这句话字面上太轻,路由题的售后选项里也没写"发错货"。这类错改题目就能修。
另一类就没这么好修。有位客户先说"我家的水管又爆了,差点把我家又淹了",发了两段视频,最后一句是"麻烦你们安排人过来处理"。安全题只问最新这一句,按字面它不算险情,Jev 给了 0.44,Decider v1.2 给了 0.17,都没报警。可在业务上,这显然是一张要优先处理的单子。安全判断不能只靠一个模型回答一道题,上文出现过的风险也得算进去。
会话质检最难。"这通会话解决了没有",最好的模型也只拿到 74 分。有一通会话,客户要转人工,人工只回了"不能的"三个字,客户就没再说话。按题目的字面,给了答复、客户没追问,算解决,21 个模型却全判了没解决。我们觉得模型这次更接近常识,该改的是题目里"解决"的定义。
这一轮的样本、题目和打分脚本都留着。再有新的决策模型出来,付费档二十分钟左右就能跑完全部样本,我们会先跑这一遍,再决定要不要在悟客里换上它。
注:本文为 2026 年 10 月的项目实践记录,数据来自已脱敏的真实客服对话。